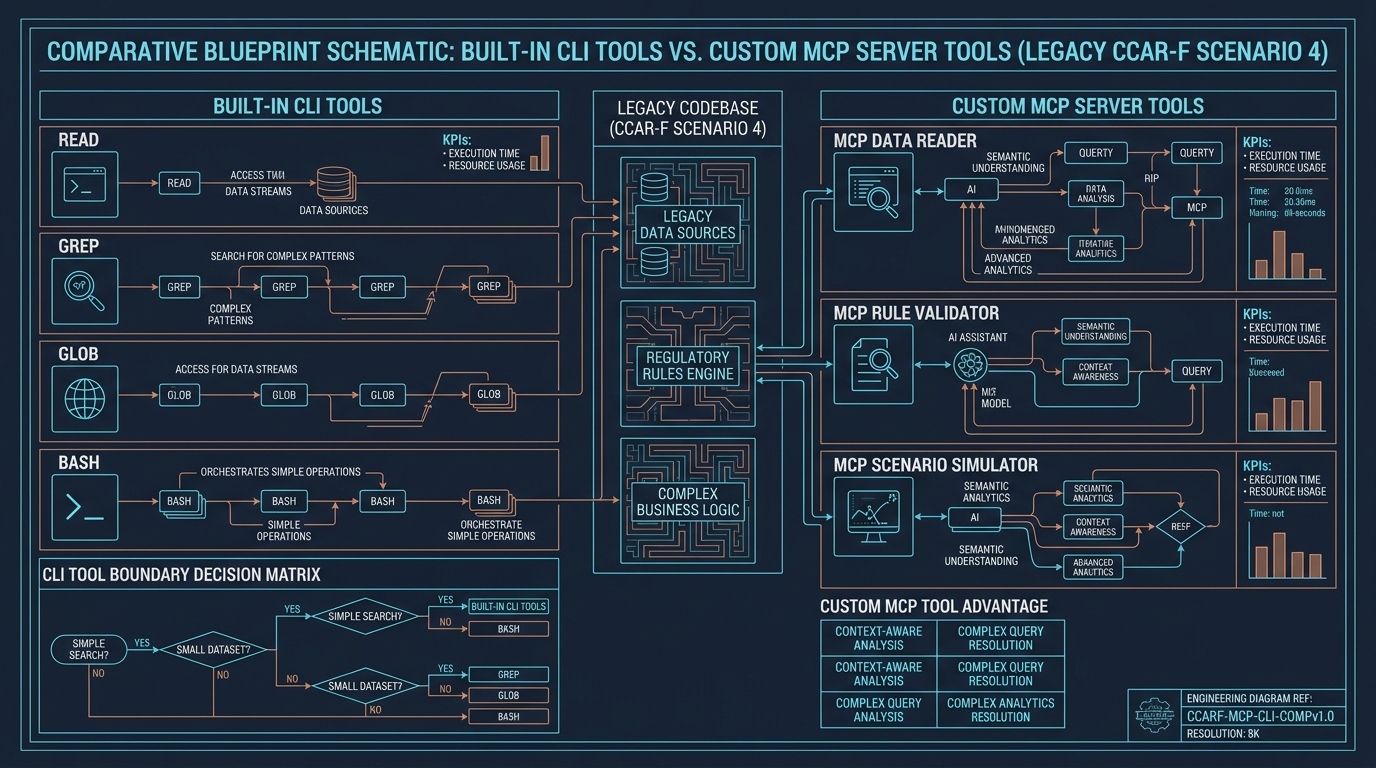
Quarto artigo da série de 6 partes sobre os cenários do CCA-F — código-fonte completo de cada cenário: labs.
O cenário, como está no exam guide
Um agente ajuda engenheiros a explorar codebases desconhecidos, entender sistemas legados e automatizar tarefas repetitivas usando tools built-in (Read, Write, Bash, Grep, Glob) e servidores MCP.
| Domínio | Peso | Onde aparece neste cenário |
|---|---|---|
| Tool Design & MCP Integration | 18% | Quais tools são genéricas e quais são construídas sob medida — e por quê |
| Claude Code Configuration & Workflows | 20% | Espelha a divisão real built-in/MCP do Claude Code, tornada explícita |
| Agentic Architecture & Orchestration | 27% | Um loop, duas fontes de tool, um system prompt dizendo qual usar |
Built-ins e servidores MCP não são intercambiáveis
Este cenário combina duas fontes de tool de propósito, e o julgamento relevante pra prova não é sintaxe — é saber qual das duas uma dada pergunta realmente exige. O script standalone do labs (ele não roda dentro do Claude Code, então não pode usar os built-ins reais) implementa equivalentes genéricos — read_file, grep_codebase, list_files — e os combina com três tools MCP customizadas: get_file_history, find_owner, find_related_tests.
A linha entre elas: uma tool genérica consegue responder isso, dado chamadas suficientes? get_file_history, find_owner e find_related_tests respondem perguntas que não são deriváveis do próprio texto do arquivo, não importa quanta leitura e grep você jogue nele — por que o código está do jeito que está, quem contatar de fato, se tem cobertura de testes. Nada disso mora dentro do arquivo. Isso é o que justifica uma tool customizada.
O erro inverso é igualmente real, e vale nomear explicitamente: uma tool sob medida read_discount_validation_logic que na verdade é só read_file com um nome mais específico adiciona superfície de manutenção sem adicionar capacidade. Se a tool genérica já consegue responder, uma customizada é teatro, não arquitetura.
O exemplo é construído pra pegar uma falha específica
O codebase-alvo é um módulo pequeno de códigos de desconto, deliberadamente armadilhado. legacy-promo-engine.ts não tem nenhum comentário explicando por que códigos LEGACY- passam por uma tabela de busca separada — você só descobre isso com get_file_history (uma campanha de 2021) e find_owner (os autores originais saíram; escalar pro #platform-oncall). apply-discount.ts tem lógica condicional de verdade e zero cobertura de testes — find_related_tests retorna um array vazio, não um erro, exatamente pra esse arquivo.
Um agente que só usasse read_file/grep_codebase conseguiria descrever o que apply-discount.ts faz com todo detalhe e nunca revelar que ele não tem rede de segurança de testes. Essa lacuna — explicação competente do código sem sinal de risco — é exatamente o que este cenário testa se um agente (e um candidato) vai pegar.
Rode você mesmo
git clone https://github.com/aicertstudy/labs
cd labs/ccar-f/scenarios/scenario-4-developer-productivity
npm install && npm test    # 3 testes passando, descobertos dentro de sample-codebase/
cp .env.example .env       # adicione sua ANTHROPIC_API_KEY

npm run agent -- "How do LEGACY- discount codes work, and who do I ask if one misbehaves?"
Observe o log de chamadas de tool: ler/grepar pro o quê, depois as tools MCP pro por quê e quem — idealmente antes do agente fazer qualquer afirmação sobre risco ou responsabilidade.
Teste seus conhecimentos
1. Qual é a pergunta decisiva pra saber se uma nova capacidade deveria ser uma tool MCP customizada ou algo alcançável com tools genéricas estilo Read/Grep?
Resposta: se uma tool genérica conseguiria responder dado chamadas suficientes — se sim, uma tool customizada adiciona superfície de manutenção sem adicionar capacidade.
Velocidade ou conveniência sozinhas não justificam uma tool sob medida. A justificativa é informacional: a resposta existe em algum lugar que uma tool genérica de arquivo/busca estruturalmente não consegue alcançar (histórico, registros de propriedade, um índice de cobertura)?
2. Por que find_related_tests retorna um array vazio pra apply-discount.ts em vez de lançar um erro?
Resposta: um array vazio é uma resposta significativa e distinta — "não existe cobertura" — não uma falha da tool em encontrar algo.
Tratar "sem resultados" como erro tornaria isso indistinguível de uma busca quebrada ou um caminho digitado errado. Um resultado vazio tipado deixa o agente chamador (e uma pessoa lendo o código) tratar "genuinamente sem testes" como seu próprio fato real e acionável.
3. Por que legacy-promo-engine.ts deliberadamente não tem comentário explicando por que os códigos LEGACY- existem?
Resposta: pra que responder "por que esse código existe" exija as tools de histórico/propriedade, não só ler o arquivo — demonstrando por que essas tools existem.
Se a explicação estivesse num comentário, uma chamada genérica de read_file já responderia a pergunta, e as tools MCP customizadas não teriam nada distinto a contribuir. A lacuna é intencional, pra tornar a lição real do domínio observável em vez de teórica.
4. Que falha um agente demonstra se explica a lógica de apply-discount.ts com precisão mas nunca checa find_related_tests?
Resposta: explicação competente do código sem sinal de risco — ele descreve corretamente o que a lógica legada não testada faz sem revelar que ela não tem rede de segurança de testes.
Precisão sobre comportamento não é o mesmo que revelar risco. Um agente (ou um engenheiro) pode estar completamente correto sobre o que o código faz e ainda falhar na tarefa real de sinalizar que uma mudança ali não tem rede de segurança.
5. Adicionar uma quarta tool MCP, find_function_definition(name), implementada internamente como um grep, seria um bom design de tool segundo o padrão deste cenário?
Resposta: não — se é só grep_codebase com um nome mais específico e nenhuma informação que uma busca genérica não conseguiria revelar, é o erro da "tool sob medida que na verdade é genérica disfarçada" que o README alerta.
O padrão não é "essa tool torna uma tarefa específica um pouco mais conveniente" — é "essa tool alcança informação que uma tool genérica estruturalmente não consegue". Uma tool baseada em grep com nome específico falha nesse teste mesmo sendo agradável de chamar.
Simulado gratuito do CCA-F, cobrindo os 5 domínios: aicert.study/certifications/ccaf.