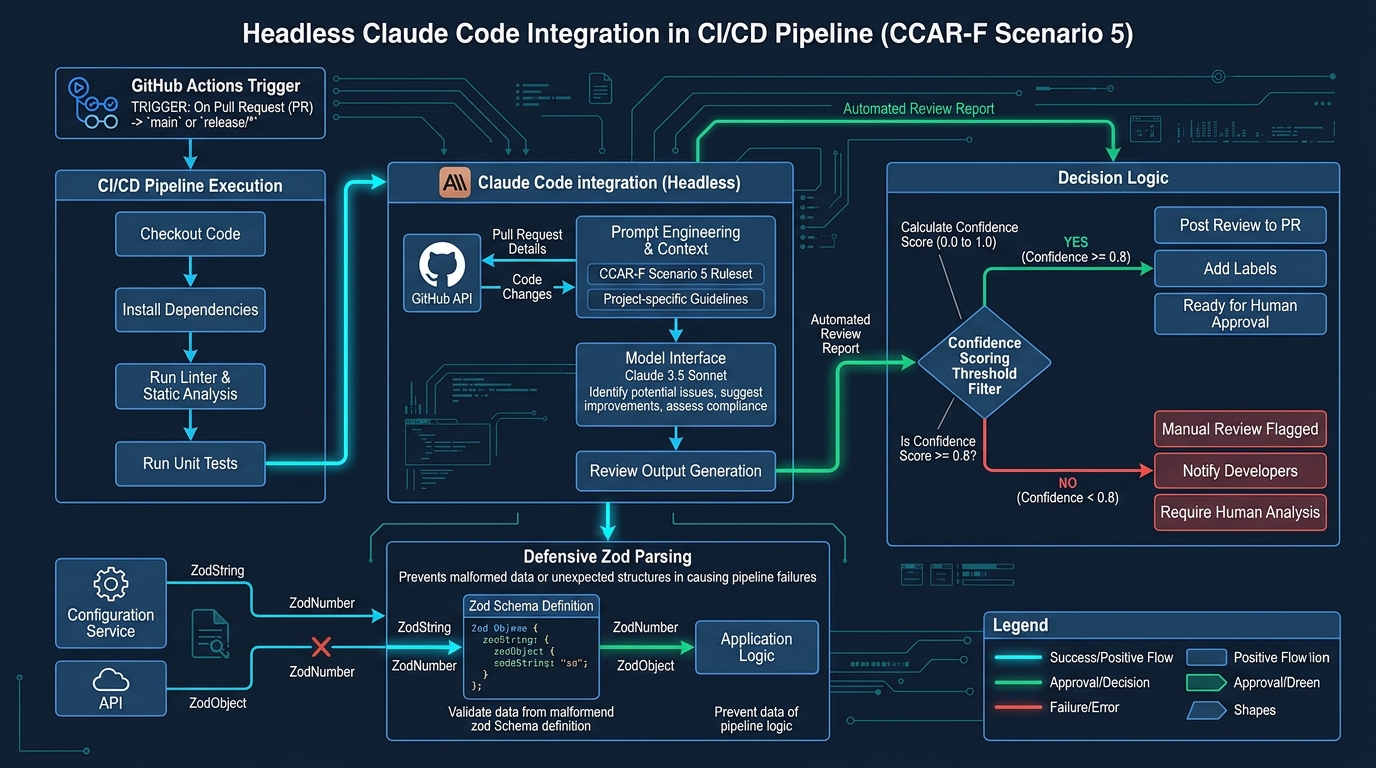
Quinto artigo da série de 6 partes sobre os cenários do CCA-F — código-fonte completo de cada cenário: labs.
O cenário, como está no exam guide
Claude Code integrado ao pipeline de CI/CD: revisão automatizada de código, geração de casos de teste e feedback em pull requests, minimizando falsos positivos.
| Domínio | Peso | Onde aparece neste cenário |
|---|---|---|
| Claude Code Configuration & Workflows | 20% | O workflow do GitHub Actions — invocação headless, permissões, repasse da saída |
| Prompt Engineering & Structured Output | 20% | Um prompt que pede uma pontuação de confiança e um cenário de falha concreto, mais um schema que valida o que volta |
O exam guide nomeia a parte difícil explicitamente, no próprio texto: minimizando falsos positivos. Tudo o mais neste cenário — rodar o Claude Code headless, postar num PR — é comparativamente mecânico.
Uma instrução de prompt não é um limiar
O conserto intuitivo é só no prompt: dizer pro modelo ser conservador, só sinalizar coisas que tem certeza. O prompts/review-prompt.md do labs faz exatamente isso — pede uma pontuação de confiança (0.0–1.0) e um cenário de falha concreto ("isso quebra sob estas condições específicas", não "isso poderia ser mais limpo") em vez de uma preocupação vaga. Isso é real, e importa.
Mas ainda é só um pedido que o modelo pode calibrar errado em qualquer execução. Um falso positivo não precisa acontecer com frequência pra treinar um time a parar de ler os comentários do bot completamente — e uma vez que isso acontece, a ferramenta fica pior do que não rodar, porque ainda consome minutos de CI e espaço na página do PR.
O src/filter-findings.ts é o portão de verdade: MIN_CONFIDENCE = 0.7, e a severidade "nitpick" é descartada incondicionalmente independente da confiança. Essa é uma segunda checagem, independente — código, não mais uma instrução de prompt pedindo pro modelo "ter certeza de verdade dessa vez". É a mesma forma do process_refund do Cenário 1: pedir educadamente no prompt, depois garantir de verdade a jusante.
Degradar, não travar
O post-review-comments.ts valida cada achado contra o mesmo schema que o prompt pede ao Claude Code que siga. Se uma entrada está malformada — um campo faltando, uma confiança fora de 0–1 — só essa entrada é registrada e descartada, não tratada como motivo pra falhar a checagem de CI inteira. Um passo de revisão que trava porque o modelo produziu um objeto JSON levemente malformado é um modo de falha pior do que um que posta três achados válidos e silenciosamente pula um quarto. Mesmo instinto do coordenador do Cenário 3 lidando com um resultado parcial de multi-agente: uma peça estruturalmente inválida é um caso esperado pra contornar, não uma exceção pra propagar.
Rode você mesmo
git clone https://github.com/aicertstudy/labs
cd labs/ccar-f/scenarios/scenario-5-claude-code-ci
npm install
npm test    # 5 testes passando na lógica de filtro/formatação

npm run post -- fixtures/sample-findings.json
O fixture tem 4 achados; observe exatamente 2 passarem no limiar (um bug real e um risco bem em 74% de confiança), enquanto um nitpick e um risco de 35% de confiança são suprimidos e registrados no log. Não precisa de GITHUB_TOKEN — sem ele, o script imprime o que teria postado em vez de chamar a API do GitHub, o que é o que torna a lógica de filtro verificável sem um PR real.
Teste seus conhecimentos
1. Por que pedir uma pontuação de confiança pro modelo no prompt não é suficiente, sozinho, pra minimizar falsos positivos?
Resposta: a pontuação de confiança ainda é algo que o modelo pode calibrar errado em qualquer execução — é um sinal, não um mecanismo de fiscalização.
Uma instrução de prompt (mesmo uma boa, pedindo confiança calibrada) só vale se o modelo se autoavaliar corretamente toda vez. Um limiar fixo checado em código não depende dessa autoavaliação ser confiável naquela execução específica que ele está protegendo.
2. Por que filterFindings descarta toda severidade "nitpick" incondicionalmente, em vez de aplicar o mesmo limiar de confiança que usa pra "bug" e "risk"?
Resposta: nitpicks são um tipo de afirmação completamente diferente — uma preferência de estilo não fica mais "verdadeira" com maior confiança do modelo, então um limiar de confiança simplesmente não se aplica a essa categoria.
Confiança mede certeza sobre uma afirmação factual (isso quebra sob estas condições). Uma preferência de estilo não é uma afirmação factual sobre a qual o modelo pode ter mais ou menos certeza no mesmo sentido — então condicionar isso à confiança seria um erro de categoria, não um filtro mais rigoroso.
3. O que acontece neste pipeline se o Claude Code escrever um achado sem o campo confidence?
Resposta: esse achado é registrado como pulado e excluído da revisão; o resto da execução prossegue normalmente.
A validação zod em post-review-comments.ts checa cada achado independentemente, então uma entrada malformada não invalida o lote inteiro — é tratada como uma falha de parsing por item, não uma falha no nível da execução.
4. No fixture de exemplo, um achado "risk" sobre percentOff ficar negativo tem 35% de confiança e é suprimido. O que precisaria mudar pra esse mesmo achado valer a pena mostrar?
Resposta: ou a confiança precisaria subir pra 70%+ (ou seja, o modelo precisaria de evidência real, não uma hipótese), ou o time precisaria deliberadamente baixar o MIN_CONFIDENCE — o que troca menos riscos reais suprimidos por mais falsos positivos.
O limiar é um único ponto de troca ajustável, não uma fronteira de correção — movê-lo não torna os achados acima "certos" e abaixo "errados", muda quanto ruído o time está disposto a tolerar em troca de pegar mais riscos limítrofes.
5. O workflow posta um comentário-resumo único em vez de comentários de revisão inline por linha. Qual detalhe da API do GitHub é o motivo desse cenário não fazer isso por padrão?
Resposta: comentários de revisão inline exigem uma position no diff (um offset dentro do diff unificado), não só um arquivo e número de linha — calcular isso corretamente é significativamente mais complexo do que postar um único comentário de issue.
Um par arquivo/linha identifica um local na versão final de um arquivo; uma posição de diff identifica um local dentro do próprio diff, que depende dos hunks exatos que o GitHub gerou pra aquele PR. Errar isso silenciosamente desloca ou falha ao postar comentários inline, por isso a implementação de referência lança primeiro a versão mais simples e sempre correta do comentário-resumo.
Simulado gratuito do CCA-F, cobrindo os 5 domínios: aicert.study/certifications/ccaf.