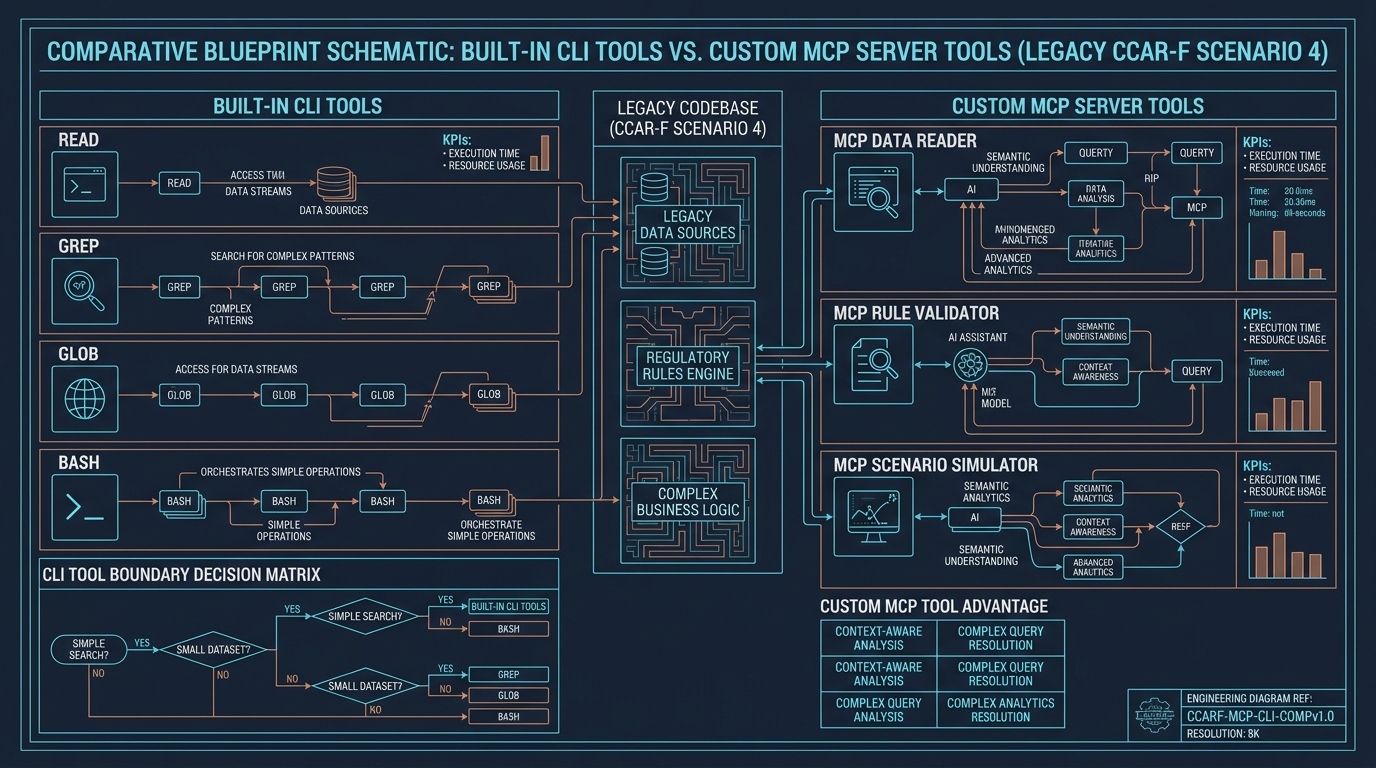
Cuarto artículo de la serie de 6 partes sobre los escenarios del CCA-F — código fuente completo de cada escenario: labs.
El escenario, tal como está en el exam guide
Un agente ayuda a los ingenieros a explorar codebases desconocidos, entender sistemas legados y automatizar tareas repetitivas usando tools built-in (Read, Write, Bash, Grep, Glob) y servidores MCP.
| Dominio | Peso | Dónde aparece en este escenario |
|---|---|---|
| Tool Design & MCP Integration | 18% | Qué tools son genéricas y cuáles están hechas a medida — y por qué |
| Claude Code Configuration & Workflows | 20% | Refleja la división real built-in/MCP de Claude Code, hecha explícita |
| Agentic Architecture & Orchestration | 27% | Un loop, dos fuentes de tools, un system prompt que indica cuál usar |
Los built-ins y los servidores MCP no son intercambiables
Este escenario combina dos fuentes de tools a propósito, y el criterio relevante para el examen no es la sintaxis — es saber cuál de las dos necesita realmente una pregunta dada. El script independiente de labs (no corre dentro de Claude Code, así que no puede usar los built-ins reales) implementa equivalentes genéricos — read_file, grep_codebase, list_files — y los combina con tres tools MCP personalizadas: get_file_history, find_owner, find_related_tests.
La línea entre ambas: ¿puede una tool genérica responder esto, con suficientes llamadas? get_file_history, find_owner y find_related_tests responden preguntas que no son derivables del propio texto del archivo, sin importar cuánta lectura y grep le apliques — por qué el código es como es, a quién contactar realmente, si tiene cobertura de pruebas. Nada de eso vive dentro del archivo. Eso es lo que justifica una tool personalizada.
El error inverso es igual de real, y vale la pena nombrarlo explícitamente: una tool a medida read_discount_validation_logic que en realidad es solo read_file con un nombre más específico añade superficie de mantenimiento sin añadir capacidad. Si la tool genérica ya puede responderlo, una personalizada es teatro, no arquitectura.
El ejemplo está construido para atrapar una falla específica
El codebase objetivo es un módulo pequeño de códigos de descuento, deliberadamente trampeado. legacy-promo-engine.ts no tiene ningún comentario que explique por qué los códigos LEGACY- pasan por una tabla de búsqueda separada — solo lo descubres con get_file_history (una campaña de 2021) y find_owner (los autores originales se fueron; escalar a #platform-oncall). apply-discount.ts tiene lógica condicional real y cero cobertura de pruebas — find_related_tests devuelve un array vacío, no un error, exactamente para ese archivo.
Un agente que solo usara read_file/grep_codebase podría describir qué hace apply-discount.ts con todo detalle y nunca revelar que no tiene red de seguridad de pruebas. Esa brecha — explicación competente del código sin señal de riesgo — es exactamente lo que este escenario evalúa si un agente (y un candidato) va a detectar.
Ejecútalo tú mismo
git clone https://github.com/aicertstudy/labs
cd labs/ccar-f/scenarios/scenario-4-developer-productivity
npm install && npm test    # 3 pruebas pasando, descubiertas dentro de sample-codebase/
cp .env.example .env       # agrega tu ANTHROPIC_API_KEY

npm run agent -- "How do LEGACY- discount codes work, and who do I ask if one misbehaves?"
Observa el registro de llamadas a tools: leer/gregar para el qué, luego las tools MCP para el por qué y el quién — idealmente antes de que el agente haga cualquier afirmación sobre riesgo o responsabilidad.
Pon a prueba tus conocimientos
1. ¿Cuál es la pregunta decisiva para saber si una nueva capacidad debería ser una tool MCP personalizada o algo alcanzable con tools genéricas estilo Read/Grep?
Respuesta: si una tool genérica podría responderlo con suficientes llamadas — si es así, una tool personalizada añade superficie de mantenimiento sin añadir capacidad.
La velocidad o la conveniencia por sí solas no justifican una tool a medida. La justificación es informacional: ¿existe la respuesta en algún lugar que una tool genérica de archivo/búsqueda estructuralmente no puede alcanzar (historial, registros de propiedad, un índice de cobertura)?
2. ¿Por qué find_related_tests devuelve un array vacío para apply-discount.ts en lugar de lanzar un error?
Respuesta: un array vacío es una respuesta significativa y distinta — "no existe cobertura" — no un fallo de la tool para encontrar algo.
Tratar "sin resultados" como error lo haría indistinguible de una búsqueda rota o una ruta mal escrita. Un resultado vacío tipado permite que el agente que llama (y una persona leyendo el código) trate "genuinamente sin pruebas" como su propio hecho real y accionable.
3. ¿Por qué legacy-promo-engine.ts deliberadamente no tiene un comentario que explique por qué existen los códigos LEGACY-?
Respuesta: para que responder "por qué existe este código" requiera las tools de historial/propiedad, no solo leer el archivo — demostrando por qué existen esas tools.
Si la razón estuviera en un comentario, una llamada genérica a read_file ya respondería la pregunta, y las tools MCP personalizadas no tendrían nada distinto que aportar. La brecha es intencional, para hacer observable la lección real del dominio en lugar de teórica.
4. ¿Qué modo de fallo exhibe un agente si explica la lógica de apply-discount.ts con precisión pero nunca revisa find_related_tests?
Respuesta: explicación competente del código sin señal de riesgo — describe correctamente lo que hace la lógica legada sin pruebas sin revelar que no tiene red de seguridad de pruebas.
La precisión sobre el comportamiento no es lo mismo que revelar el riesgo. Un agente (o un ingeniero) puede estar completamente en lo correcto sobre lo que hace el código y aun así fallar en la tarea real de señalar que un cambio ahí no tiene red de seguridad.
5. ¿Sería una buena decisión de diseño, según el estándar de este escenario, añadir una cuarta tool MCP, find_function_definition(name), implementada internamente como un grep?
Respuesta: no — si es solo grep_codebase con un nombre más específico y ninguna información que una búsqueda genérica no pudiera revelar ya, es el error de "tool a medida que en realidad es genérica disfrazada" que advierte el README.
El estándar no es "esta tool hace una tarea específica un poco más conveniente" — es "esta tool alcanza información que una tool genérica estructuralmente no puede". Una tool basada en grep con un nombre específico falla esa prueba aunque sea agradable de llamar.
Simulacro gratuito del CCA-F, cubriendo los 5 dominios: aicert.study/certifications/ccaf.