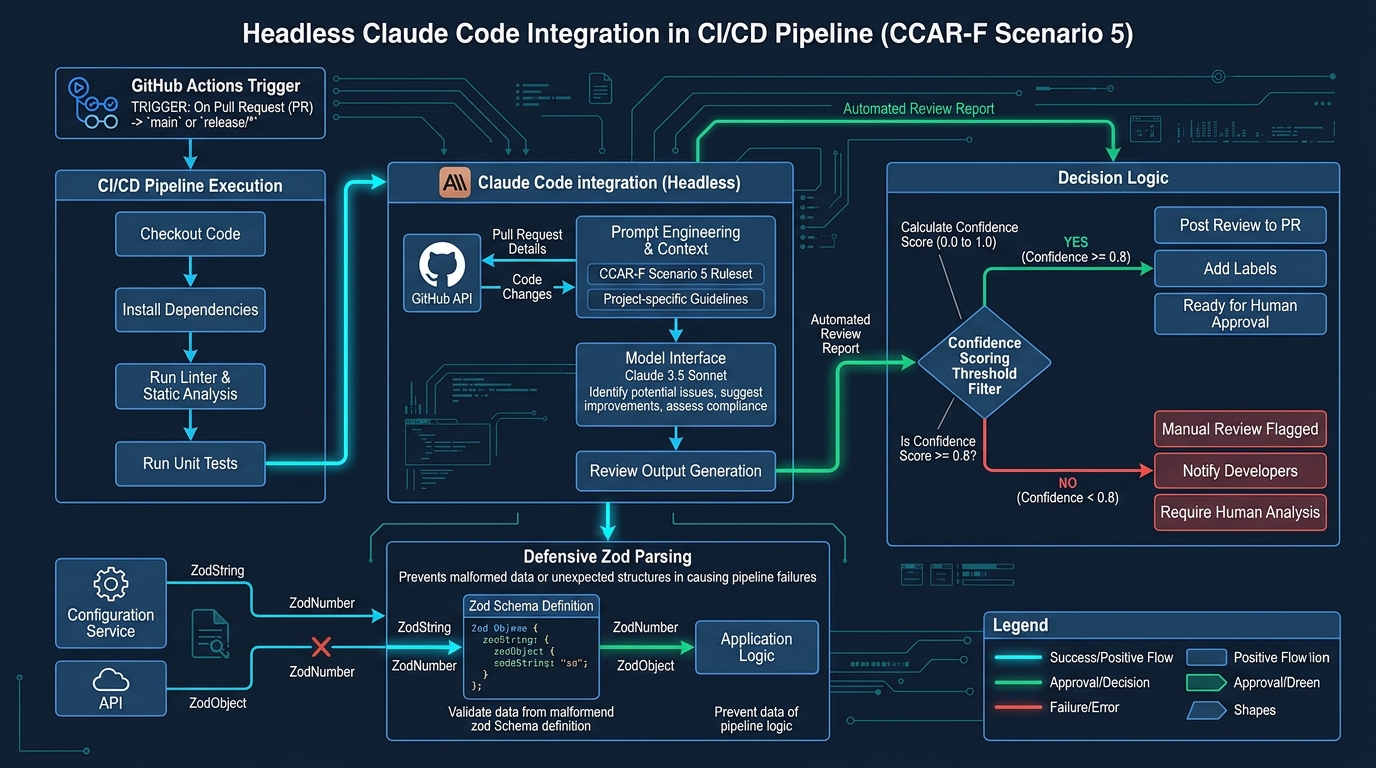
Quinto artículo de la serie de 6 partes sobre los escenarios del CCA-F — código fuente completo de cada escenario: labs.
El escenario, tal como está en el exam guide
Claude Code integrado en el pipeline de CI/CD: revisión automatizada de código, generación de casos de prueba y feedback en pull requests, minimizando falsos positivos.
| Dominio | Peso | Dónde aparece en este escenario |
|---|---|---|
| Claude Code Configuration & Workflows | 20% | El workflow de GitHub Actions — invocación headless, permisos, traspaso de la salida |
| Prompt Engineering & Structured Output | 20% | Un prompt que pide una puntuación de confianza y un escenario de fallo concreto, más un schema que valida lo que regresa |
El exam guide nombra la parte difícil explícitamente, en su propio texto: minimizando falsos positivos. Todo lo demás en este escenario — ejecutar Claude Code headless, publicar en un PR — es comparativamente mecánico.
Una instrucción de prompt no es un umbral
El arreglo intuitivo es solo en el prompt: decirle al modelo que sea conservador, que solo señale cosas de las que esté seguro. El prompts/review-prompt.md de labs hace exactamente eso — pide una puntuación de confianza (0.0–1.0) y un escenario de fallo concreto ("esto se rompe bajo estas condiciones específicas", no "esto podría ser más limpio") en lugar de una preocupación vaga. Eso es real, y importa.
Pero sigue siendo solo una solicitud que el modelo puede calibrar mal en cualquier ejecución. Un falso positivo no tiene que ocurrir con frecuencia para entrenar a un equipo a dejar de leer los comentarios del bot por completo — y una vez que eso pasa, la herramienta es peor que no ejecutarla, porque sigue consumiendo minutos de CI y espacio en la página del PR.
src/filter-findings.ts es la puerta real: MIN_CONFIDENCE = 0.7, y la severidad "nitpick" se descarta incondicionalmente sin importar la confianza. Esa es una segunda verificación, independiente — código, no otra instrucción de prompt pidiéndole al modelo que "esté realmente seguro esta vez". Es la misma forma que process_refund del Escenario 1: pedir amablemente en el prompt, luego aplicar de verdad río abajo.
Degradar, no fallar por completo
post-review-comments.ts valida cada hallazgo contra el mismo schema que el prompt le pide a Claude Code que siga. Si una entrada está mal formada — un campo faltante, una confianza fuera de 0–1 — solo esa entrada se registra y se descarta, no se trata como motivo para fallar toda la verificación de CI. Un paso de revisión que falla por completo porque el modelo produjo un objeto JSON ligeramente mal formado es un modo de fallo peor que uno que publica tres hallazgos válidos y omite silenciosamente un cuarto. Mismo instinto que el coordinador del Escenario 3 manejando un resultado parcial de multi-agente: una pieza estructuralmente inválida es un caso esperado que se debe evitar, no una excepción que se debe propagar.
Ejecútalo tú mismo
git clone https://github.com/aicertstudy/labs
cd labs/ccar-f/scenarios/scenario-5-claude-code-ci
npm install
npm test    # 5 pruebas pasando en la lógica de filtro/formato

npm run post -- fixtures/sample-findings.json
El fixture tiene 4 hallazgos; observa exactamente 2 que superan el umbral (un bug real y un riesgo justo en 74% de confianza), mientras que un nitpick y un riesgo con 35% de confianza se suprimen y quedan registrados. No se necesita GITHUB_TOKEN — sin él, el script imprime lo que habría publicado en lugar de llamar a la API de GitHub, que es lo que hace que la lógica de filtrado sea verificable sin un PR real.
Pon a prueba tus conocimientos
1. ¿Por qué pedirle al modelo una puntuación de confianza en el prompt no es suficiente, por sí solo, para minimizar falsos positivos?
Respuesta: la puntuación de confianza sigue siendo algo que el modelo puede calibrar mal en cualquier ejecución — es una señal, no un mecanismo de aplicación.
Una instrucción de prompt (incluso una buena, pidiendo confianza calibrada) solo se sostiene si el modelo se autoevalúa correctamente cada vez. Un umbral fijo verificado en código no depende de que esa autoevaluación sea confiable en la ejecución específica que está protegiendo.
2. ¿Por qué filterFindings descarta toda severidad "nitpick" incondicionalmente, en lugar de aplicar el mismo umbral de confianza que usa para "bug" y "risk"?
Respuesta: los nitpicks son un tipo de afirmación completamente distinto — una preferencia de estilo no se vuelve más "verdadera" con mayor confianza del modelo, así que un umbral de confianza simplemente no aplica a esa categoría.
La confianza mide certeza sobre una afirmación factual (esto se rompe bajo estas condiciones). Una preferencia de estilo no es una afirmación factual sobre la que el modelo pueda tener más o menos certeza en el mismo sentido — así que condicionarla a la confianza sería un error de categoría, no un filtro más estricto.
3. ¿Qué pasa en este pipeline si Claude Code escribe un hallazgo sin el campo confidence?
Respuesta: ese hallazgo se registra como omitido y se excluye de la revisión; el resto de la ejecución continúa con normalidad.
La validación de zod en post-review-comments.ts verifica cada hallazgo de forma independiente, así que una entrada mal formada no invalida todo el lote — se trata como un fallo de parseo por elemento, no un fallo a nivel de ejecución.
4. En el fixture de ejemplo, un hallazgo "risk" sobre que percentOff se vuelva negativo tiene 35% de confianza y se suprime. ¿Qué tendría que cambiar para que ese mismo hallazgo valiera la pena mostrarlo?
Respuesta: o su confianza tendría que subir a 70%+ (es decir, el modelo necesitaría evidencia real, no una hipótesis), o el equipo tendría que bajar deliberadamente MIN_CONFIDENCE — lo cual cambia menos riesgos reales suprimidos por más falsos positivos.
El umbral es un único punto de compensación ajustable, no una frontera de corrección — moverlo no hace que los hallazgos por encima sean "correctos" y los de abajo "incorrectos", cambia cuánto ruido está dispuesto a tolerar el equipo a cambio de detectar más riesgos límite.
5. El workflow publica un comentario resumen único en lugar de comentarios de revisión en línea por línea. ¿Qué detalle de la API de GitHub es la razón por la que este escenario no hace eso por defecto?
Respuesta: los comentarios de revisión en línea requieren una position en el diff (un desplazamiento dentro del diff unificado), no solo un archivo y número de línea — calcular eso correctamente es notablemente más complejo que publicar un único comentario de issue.
Un par archivo/línea identifica una ubicación en la versión final de un archivo; una posición de diff identifica una ubicación dentro del propio diff, que depende de los hunks exactos que GitHub generó para ese PR. Equivocarse aquí desplaza silenciosamente o falla al publicar comentarios en línea, por lo que la implementación de referencia lanza primero la versión más simple y siempre correcta del comentario resumen.
Simulacro gratuito del CCA-F, cubriendo los 5 dominios: aicert.study/certifications/ccaf.